
一篇让你从零搞懂 LangGraph 工具调用的实战教程。用真实可跑的项目讲透:图怎么搭、工具怎么注册、Text-to-SQL 怎么做、流式 Web 界面怎么实现。
面向读者
源码:https://github.com/chengpei/langgraph-demo
-
了解 Python 和基本 LLM 概念,但没接触过 LangGraph
-
想把"自然语言 → 数据库查询"这类能力做进自己的应用
-
需要监控以下工程要点:记忆、流式输出、只读安全、多轮对话
1. 我们要做什么
一个能听懂业务问题的 AI 助手:
"学生张三8月考试总分多少?" → 258 分

"三年级1班9月总分最高是谁?" → 王五(278 分)

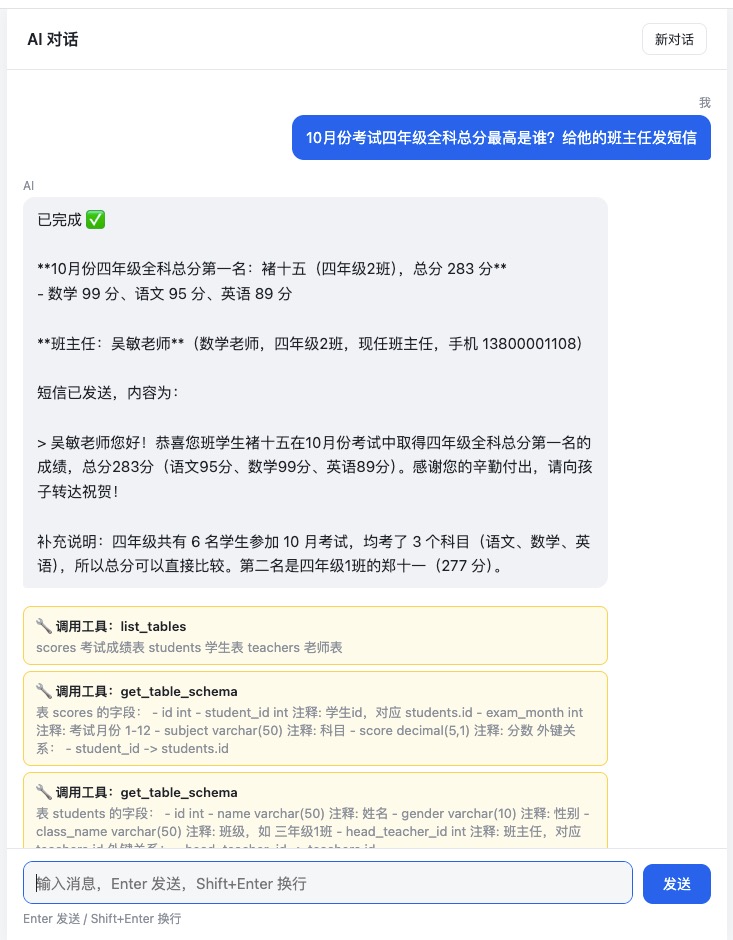
"四年级10月总分第一名是谁?" → 褚十五(283 分)

"给刘芳老师发短信通知开会" → 打印模拟短信日志
核心不是写死规则,而是一个大模型自主决定"要不要调工具、调哪个工具、怎么调"——这就是 Agent(或者说 ReAct 模式)。
技术栈
-
LangGraph(图执行框架)+ LangChain(模型与工具抽象)+ DeepSeek(OpenAI 兼容协议)
-
pymysql 连 MySQL 成绩库
-
FastAPI + SSE 做流式 Web 界面
2. LangGraph 的核心概念
LangGraph 把 Agent 建模成一张 有向图:
| 概念 | 是什么 | 在这个项目里的体现 |
|---|---|---|
| State | 图里流动的数据 | MessagesState,即一段消息列表 |
| Node | 一个处理单元 | LLM 节点、工具节点 |
| Edge | 节点之间的跳转 | 入口、循环、结束 |
| 条件边 | 根据结果决定走哪条 | LLM 是否要调工具 |
| 编译 compile() | 把图变成可执行对象 | graph = builder.compile() |
一个完整的 ReAct 循环长这样:
┌──────────────────────────────────┐
│ ▼
START → [llm 节点] → 条件边: 要调工具? ──是──→ [tools 节点] ──┐
│ │ │
│ └──── 否 ──→ END │
└────────────────────────────── 回到 llm ─────────────┘
理解点:Agent 的本质就是这个循环。LLM 判断要不要工具 → 要就去执行 → 结果回填 → 再让 LLM 看,直到它觉得够了。
3. 第一步:写一个工具
工具就是一个普通 Python 函数,用 @tool 装饰。工具描述(docstring)和类型注解会作为"说明书"发给大模型,模型就是据此决定何时调用、传什么参。
# weather.py

from langchain.tools import tool


@tool

def  get_weather(city: str) -> str:

"""查询指定城市的天气情况。


Args:

city: 城市名称,例如武汉、北京、上海

"""

data = {"武汉": "晴天 25℃,", "北京": "多云 20℃"}

return data.get(city, f"没有 {city} 的天气数据")
关键点:工具描述就是给模型看的提示词
模型能看到的就是:
工具名 get_weather,参数 {city: string}

描述:/查询指定城市的天气情况。Args: city: 城市名称.../
所以工具要认真写 docstring——它就是喂给模型的系统提示的一部分。
4. 第二步:把图和工具组装起来(agent.py)
这是核心文件,几十行代码搭出整个 Agent:
from langgraph.graph import StateGraph, MessagesState, START, END

from langgraph.prebuilt import ToolNode


# 1) 绑好工具的模型

tools = [get_weather, list_tables, get_table_schema, query_database, send_sms]

model_with_tools = model.bind_tools(tools)


# 2) LLM 节点:把整段历史丢给模型

def  llm_node(state: MessagesState):

response = model_with_tools.invoke(state["messages"])

return {"messages": [response]} # 新消息追加回 state


# 3) 条件路由:最后一条消息带没带工具调用

def  should_continue(state: MessagesState) -> Literal["tools", "__end__"]:

last = state["messages"][-1]

if last.tool_calls:

return  "tools"

return END


# 4) 搭图

builder = StateGraph(MessagesState)

builder.add_node("llm", llm_node)

builder.add_node("tools", ToolNode(tools)) # 预置节点,自动执行工具调用


builder.add_edge(START, "llm")

builder.add_conditional_edges("llm", should_continue,

{"tools": "tools", END: END})

builder.add_edge("tools", "llm") # 工具执行完必回 LLM


graph = builder.compile()
逐行讲透
-
bind_tools(tools):把一套工具能力"绑定"到模型上。模型从此知道有哪些工具可用。 -
ToolNode(tools):LangGraph 预置的工具执行器。你只需要传工具列表,它会自动从 LLM 的tool_calls里取出参数、调用对应函数、再把ToolMessage结果写回 state。 -
add_conditional_edges:路由的开关。should_continue看最后一条消息有没有tool_calls,有则去 tools,没有则END。 -
关键:
bind_tools和ToolNode共用同一个tools列表。加一个新工具,只需往列表里加一个元素,全项目自动生效。
5. 第三步:Text-to-SQL —— 让 AI 查数据库
直接问"张三8月总分",模型可不会 SQL——它是先查表结构、再自己生成 SQL、再执行。这里有个关键设计。
为什么不能把表结构硬编码进提示词?
如果把 3 张表的字段贴在工具描述里,够用;但真实数据库往往有几十上百张表,字段全塞进去会把上下文撑爆、模型也犯迷糊。所以本项目用渐进式 schema 发现——把"看结构"也变成工具,让模型按需去取。
db.py 里是数据库三件套:
| 工具 | 作用 | 何时用 |
|---|---|---|
list_tables() |
列出所有表名和注释 | 先确认有哪些表、表名拼写 |
get_table_schema(表) |
单表字段 + 外键 | 看要查的表长什么样 |
query_database(sql) |
执行只读 SELECT | 生成 SQL 后查询 |
@tool

def  get_table_schema(table_name: str) -> str:

"""获取指定表的字段结构和外键关系。"""

# 查 information_schema.columns 拿字段

# 查 information_schema.key_column_usage 拿外键 → 让模型会写 JOIN

return  "表 students 的字段:\n - id int\n - name varchar(50) 注释: 姓名\n ..."
这样模型每次只取最相关的几张表,表再多载荷也恒定。
完整执行轨迹(真实跑出来的)
问题: 学生张三8月考试总分多少?


[模型] list_tables() # 第一步,看有哪些表

[工具] scores/ students/ teachers

[模型] get_table_schema(scores) # 第二步,看相关表结构

get_table_schema(students)

[工具] 两张表的字段 + 外键

[模型] query_database("SELECT ... JOIN ... WHERE name='张三' AND exam_month=8")

[工具] 查询结果

[模型] 张三8月总分 258 分 # 第三步,面向用户作答
有趣的是:模型没有直接问"张三",而是自己推理出要用
JOIN把学生表和成绩表连起来,再按月份过滤、求和。规划和写 SQL 都是模型在工具返回的信息基础上自主完成的。
只读安全(很重要的一个工程点)
AI 能生成 SQL 就有"手滑"风险。本项目做了双重保险:
# 1) 黑名单 + 只允许 SELECT

if not stmt.upper().startswith("SELECT"):

return  "仅允许 SELECT 查询"

if 命中 DROP/UPDATE/DELETE/ALTER...:

return  "检测到禁止的关键字"


# 2) 连接级只读

cur.execute("SET SESSION TRANSACTION READ ONLY")
这样即使模型"发挥过头",也动摇不了数据库。
出错自动自愈
query_database 执行出错时,把错误信息原样返回给模型,让它在下一轮自己修正 SQL 重试——这是 ReAct 循环天然带来的好处。
6. 第四步:多轮对话记忆(checkpointer)
同一个用户连问两句,AI 得记得上文。LangGraph 用 checkpointer 解决:
from langgraph.checkpoint.memory import InMemorySaver

graph = builder.compile(checkpointer=InMemorySaver())
调用时带上 thread_id,同一 thread_id 的消息历史自动累积为一个会话:
config = {"configurable": {"thread_id": "user-123"}}

graph.invoke({"messages": [HumanMessage(content=q)]}, config=config)
内存版够了;要重启不丢,换成 SQLite/Postgres saver 即可,接口不变。
7. 第五步:流式 Web 界面(FastAPI + SSE)
控制台能对话,但要有更好的体验得给 Web。用 SSE(Server-Sent Events) 把 AI 的 token 流式推给浏览器。
# app.py —— 关键:stream_mode="messages" 逐块拿消息

async  for message, metadata in graph.astream(inputs, config,

stream_mode="messages"):

node = metadata.get("langgraph_node")

if  isinstance(message, ToolMessage):

yield sse({"type": "tool", "name": message.name, "content": message.content})

elif node == "llm" and message.content:

yield sse({"type": "token", "content": message.content})
前端一个值得讲的小优化
AI 调工具前常先冒一句"我来查一下成绩",这句不该当成正式回答。前端处理:
-
平时照常流式显示 token(纯文字问答体验不打折)
-
一旦收到
tool事件,清掉之前的前置话,只展示工具卡片 -
工具执行完后的 token 才作为最终回复显示
效果:先出"🔧 调用工具:query_database"卡片,工具结束后才出正式回答,过程一目了然。
8. 完整跑一遍(真实演示)
问:“四年级10月总分第一名是谁?”
前端 后端 Agent

───────── ──────────────

用户问题 ──────────────▶ [llm] 规划:需要查数据库

[工具] list_tables → get_table_schema(students/scores)

[工具] query_database(JOIN 按 SUM 降序)

◀── "🔧 调用工具"事件 ──

◀── "🔧 调用工具"事件 ──

◀── token 流:"四年级10月总分第一名是褚十五(283 分)..."
AI 会自己算出褚十五,还主动补了前五名排名表。
评论区